
10. Arquitectura RAG Completa: Chatea con Tus Documentos y Base de Datos
Diseña el flujo end-to-end de Generación Aumentada por Recuperación: ingesta de documentos, retrieval dinámico y respuesta sustentada.
¿Por qué RAG y no Fine-Tuning?
Cuando una empresa desea que un LLM responda dudas sobre su manual interno de empleados, sus políticas de reembolso o su catálogo de productos, el impulso común es pensar en "reentrenar" o hacer "Fine-Tuning" del modelo. Sin embargo, en la práctica el Fine-Tuning es costoso, lento y sirve para enseñar estilo o formato de respuesta, no para inyectar conocimiento fáctico actualizable.
La solución estándar de la industria es RAG (Retrieval-Augmented Generation o Generación Aumentada por Recuperación): un patrón arquitectónico donde el servidor busca en tiempo real los fragmentos de documentos más relevantes para la pregunta del usuario y los inyecta dinámicamente en el system prompt como contexto de verdad incuestionable.
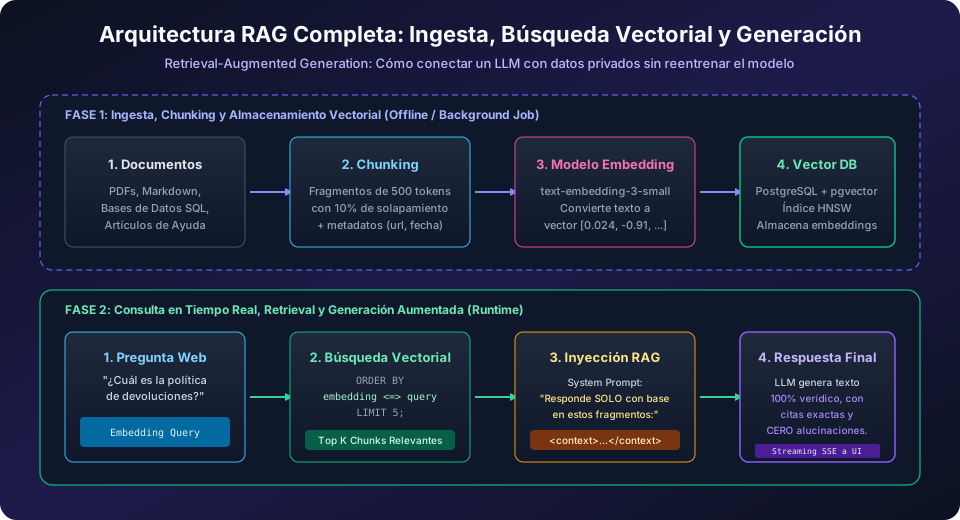
Diagrama 10.1: Las dos fases de RAG: Fase 1 de Ingesta Vectorial (Offline) y Fase 2 de Recuperación y Generación (En tiempo real).
Las Reglas de Oro para Eliminar Alucinaciones en RAG
Para garantizar que el LLM nunca invente respuestas, el prompt de sistema debe implementar tres barreras de contención:
- Principio de Contexto Cerrado: Indicarle explícitamente: "Responde ÚNICAMENTE basándote en la información dentro de las etiquetas <context>. No utilices conocimientos externos previos."
- Salida de Escape Honesta: Establecer: "Si la respuesta no se encuentra en el contexto, di claramente: 'No dispongo de esa información en los documentos suministrados'. Jamás adivines."
- Citación de Fuentes: Exigir que mencione el ID o título del documento fuente al final de cada afirmación.
⚡ Pipeline RAG en PHP: Búsqueda Vectorial e Inyección de Contexto
Servicio que toma la pregunta del usuario, busca en pgvector los 3 chunks más cercanos y ensambla el prompt enriquecido para el LLM.
<?php
declare(strict_types=1);

namespace App\Services;

class RagService
{
    private \PDO $pdo;
    private string $apiKey;

    public function __construct(\PDO $pdo, string $apiKey)
    {
        $this->pdo = $pdo;
        $this->apiKey = $apiKey;
    }

    /**
     * Responde una pregunta del usuario sustentándose 100% en documentos internos.
     */
    public function askInternalAssistant(string $userQuestion): string
    {
        // 1. Convertir la pregunta del usuario en vector de embeddings
        $queryEmbedding = $this->createEmbedding($userQuestion);

        // 2. Recuperar (Retrieval) los 3 fragmentos más relevantes de la BD
        $stmt = $this->pdo->prepare('
            SELECT id, titulo, contenido, (1 - (embedding <=> :vector::vector)) AS similitud
            FROM documentos_empresa
            ORDER BY embedding <=> :vector::vector ASC
            LIMIT 3
        ');
        $stmt->execute(['vector' => json_encode($queryEmbedding)]);
        $chunks = $stmt->fetchAll(\PDO::FETCH_ASSOC);

        // 3. Ensamblar el contexto delimitado con etiquetas XML
        $contextText = "";
        foreach ($chunks as $c) {
            $contextText .= "[Doc #{$c['id']}: {$c['titulo']}]\n{$c['contenido']}\n\n";
        }

        // 4. Construir System Prompt con instrucciones estrictas de contención
        $systemPrompt = <<<PROMPT
Eres el asistente interno de soporte de Kilopolis.
Responde a la pregunta del usuario basándote EXCLUSIVAMENTE en la siguiente información oficial:

<context>
{$contextText}
</context>

REGLAS OBLIGATORIAS:
1. Responde únicamente con hechos presentes dentro de las etiquetas <context>.
2. Si el contexto no contiene la respuesta exacta, responde textualmente: "No encuentro esa información en los manuales de la empresa."
3. Cita siempre el título o número del documento de donde extrajiste el dato.
PROMPT;

        // 5. Generar la respuesta final con el LLM
        return $this->callLlm($systemPrompt, $userQuestion);
    }

    private function createEmbedding(string $text): array
    {
        $ch = curl_init('https://api.openai.com/v1/embeddings');
        curl_setopt_array($ch, [
            CURLOPT_POST           => true,
            CURLOPT_RETURNTRANSFER => true,
            CURLOPT_HTTPHEADER     => [
                'Content-Type: application/json',
                'Authorization: Bearer ' . $this->apiKey
            ],
            CURLOPT_POSTFIELDS     => json_encode([
                'model' => 'text-embedding-3-small',
                'input' => $text
            ])
        ]);
        $res = json_decode((string)curl_exec($ch), true);
        curl_close($ch);
        return $res['data'][0]['embedding'] ?? [];
    }

    private function callLlm(string $systemPrompt, string $userQuestion): string
    {
        $ch = curl_init('https://api.openai.com/v1/chat/completions');
        curl_setopt_array($ch, [
            CURLOPT_POST           => true,
            CURLOPT_RETURNTRANSFER => true,
            CURLOPT_HTTPHEADER     => [
                'Content-Type: application/json',
                'Authorization: Bearer ' . $this->apiKey
            ],
            CURLOPT_POSTFIELDS     => json_encode([
                'model'       => 'gpt-4o-mini',
                'temperature' => 0.0,
                'messages'    => [
                    ['role' => 'system', 'content' => $systemPrompt],
                    ['role' => 'user', 'content' => $userQuestion]
                ]
            ])
        ]);
        $res = json_decode((string)curl_exec($ch), true);
        curl_close($ch);
        return (string)($res['choices'][0]['message']['content'] ?? '');
    }
}Mini-Quiz de Retención
Comprueba tu comprensión antes de pasar a la siguiente lección¿Cuál es la principal ventaja de implementar RAG frente a hacer Fine-Tuning para responder dudas sobre documentos corporativos?
¿Tienes dudas con este tema?
Sócrates AI puede darte analogías y explicarte este código paso a paso.🚀 ¿Quieres dominar IA Aplicada a Desarrollo Web: APIs, RAG & Agentes y crear proyectos reales?
Aprende arquitectura limpia, desarrollo web moderno, buenas prácticas y despliegue en producción con nuestro Bootcamp Fullstack Developer con mentorías en vivo.
🏛️ Autoría y Propiedad Intelectual: Obra educativa original de David Amador para Kilopolis Academia (Solucionáticos), estructurada sobre las especificaciones y estándares abiertos del W3C, el estándar vivo de WHATWG y la documentación oficial de código abierto. © Todos los derechos reservados.